Архитектура поиска
Как связаны поиск сообщений, граф разговоров, embeddings и доказательные источники.
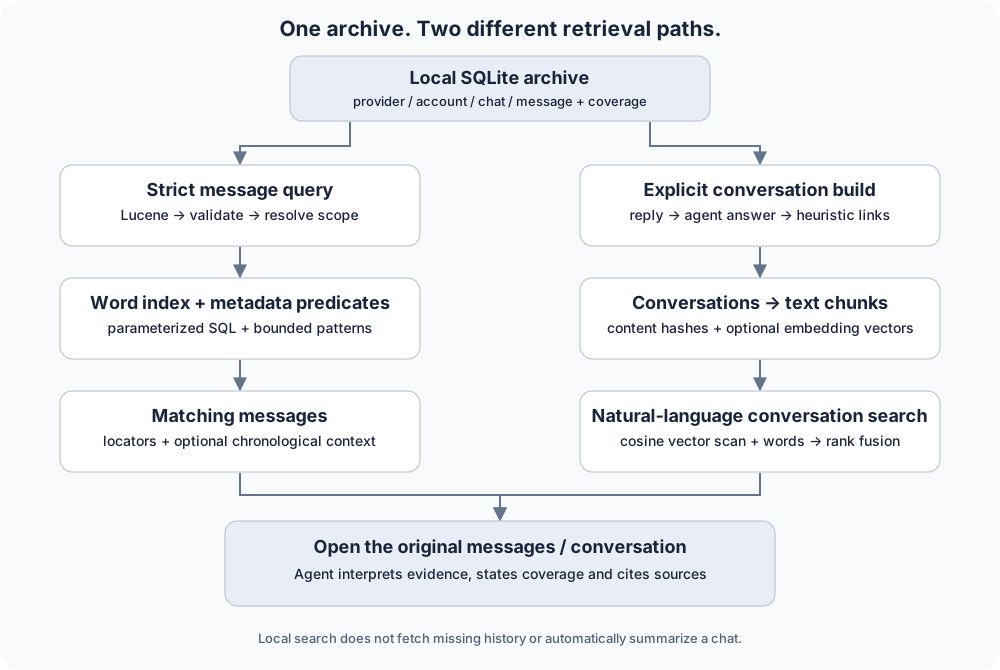
В WireCat есть два пути поиска по общему локальному архиву: строгий поиск сообщений находит сообщения, соответствующие запросу, а поиск разговоров — обсуждения, близкие по смыслу и словам. Граф связей и embeddings уже реализованы. Это дополнительные этапы обработки, отдельные от поиска сообщений на языке Lucene.
Описание основано на реализации, прочитанной 4 октября 2026 года. Подробности команд — в руководствах по поиску Telegram и MAX и страницах архива. Ссылки на исходники фиксируют исследованную версию движка, а не обещают, что она уже установлена в каждом CLI.
Какой путь выбрать
| Вопрос | Команда | Результат | Подготовка |
|---|---|---|---|
| «Где Alice упомянула invoice в октябре и приложила файл?» | messages search | Совпавшие сообщения, locators и соседний контекст | Сохранённая история; готовый word index для текстовых условий |
| «Где мы обсуждали аренду квартиры?» | conversations search | Разговоры по релевантности, совпавшие chunks и способ поиска | Построенные разговоры; embeddings для поиска по смыслу |
| «К какому разговору относится это сообщение?» | conversations show / messages links | Участники разговора, возможные связи и выбранная цепочка родителей | Построенные разговоры |
| «Что писали рядом с этим сообщением?» | messages context / --context | Хронологические соседи в том же аккаунте и чате | Сохранённая история; граф и embeddings не нужны |
Тема мессенджера, восстановленный разговор и окно соседних сообщений — разные вещи. Разговор может связывать сообщения, не стоящие рядом; хронологические соседи могут обсуждать другое.
1. Архив и идентичность
Чтение, явный fetch истории и включённый сбор новых сообщений сохраняют данные в общей SQLite. Поиск читает эту копию и не скачивает незаметно всю удалённую историю. Provider/account/chat/message позволяют отличить одинаковые номера сообщений в разных источниках. В ответах есть квалифицированные locators для перехода к оригиналу.
Исходный текст и metadata провайдера хранятся отдельно от нормализованного текста индекса. Архив учитывает известные диапазоны истории и полноту. Готовый индекс, разговор или вектор не доказывает, что скачан весь чат.
Строгий поиск начинает с активного аккаунта. --source all или in:all явно расширяет область до аккаунтов, сохранённых в store; provider scope сужает её. Имена разрешаются внутри выбранной области. Неоднозначные авторы и чаты требуют точного идентификатора или более узкого scope.
Поиск разговоров сейчас ограничен одним аккаунтом: построенными разговорами активного аккаунта, при необходимости одним чатом и временем. Аналога --source all у него нет. Межмессенджерный поиск сообщений не означает межмессенджерный semantic search.
2. Строгий поиск сообщений на языке Lucene
Путь выполнения:
- Текст разбирается в versioned Boolean AST с позициями для ошибок. Используется проверенный профиль грамматики Lucene; это язык запросов, а не сервер Elasticsearch или Java-индекс Lucene.
- Один registry проверяет поля, значения и операторы. CLI text и MCP text/AST обращаются к одному service.
- Разрешаются accounts, локальные имена и календарные даты.
topic:требует одного обязательного чата: номера тем локальны внутри чата. - AST превращается в параметризованные SQLite predicates. Термы и фразы используют FTS5 word index по нормализованному тексту; metadata ограничивает сообщения-кандидаты.
- Wildcard/regex по словам раскрываются через словарь индекса. Проверки полного текста и preset detectors выполняются с ограниченными бюджетами. Regex использует ограниченный автомат, а не произвольный backtracking.
- Ранжируются только удовлетворяющие запросу сообщения; затем при необходимости читаются их хронологические соседи в исходном аккаунте/чате. Ранжирование не расширяет Boolean множество.
Реализованы text, body, from, chat, date, kind, has, topic, in и поддержанный набор preset. filename/mime/size/tag, fuzzy/proximity/boost/intervals в этом профиле не реализованы и дают явную ошибку.
tg messages search 'invoice AND has:file' --source all --context 2 --json
max messages search 'chat:"Project team" AND date:[2026-10-01 TO 2026-10-31]' --timezone Europe/Madrid --json
text сопоставляет нормализованные слова, body — весь исходный текст. body:/.*invoice.*/ задаёт поиск вхождения в полном тексте. Regex имеет свой поддержанный subset; JavaScript flags, lookaround и backreferences не являются его аналогами.
ISO date без времени означает календарный день в выбранном IANA timezone. Inclusive upper day включает весь день, exclusive исключает его. Границы учитывают DST, а не предполагают ровно 24 часа в каждом дне.
Неготовый word index требует обслуживания: строгий поиск не заменяет его подстрочной выдачей. Ограничены размер запроса, глубина AST, автомат, раскрытие словаря, кандидаты, прочитанные байты, работа и время. Исчерпание бюджета — ошибка, а не полный пустой результат.
Ответ содержит версии query/fields/presets, timezone, порядок, wordsReady, accounts/chat coverage и completeness даже при нуле совпадений. Сейчас inventoryComplete: false, lastSyncedAt: null: это не подтверждение полного списка чатов или недавней синхронизации. JSONL передаёт items; для полной оболочки используйте JSON.
Legacy discovery и JavaScript --regex — отдельные явно выбранные режимы. Их исправление опечаток и fallback не входят в строгую семантику Lucene.
3. Граф связей и восстановление разговоров
conversations build читает один сохранённый чат в хронологическом порядке. Сообщение может иметь несколько candidate links к более ранним сообщениям. Выбранный родитель присоединяет его к существующему разговору; отсутствие родителя начинает новый.
Приоритет сейчас такой:
- Reply провайдера: явный ответ на более раннее сообщение, имеющееся в build, побеждает.
- Ответ агента: сохранённый корректный ответ вашего агента может выбрать предыдущего родителя или начать новый разговор.
- Правила: наиболее уверенный кандидат по упоминанию или продолжению того же автора.
Упоминания смотрят назад до 50 сообщений и учитывают native thread ID, если он сохранён. Продолжение автора ищется в последних 10 сообщениях и пяти минутах, также в том же thread. Веса правил — эвристики, а не калиброванная вероятность правильности. Явный reply может уходить дальше, если родитель есть в загруженном чате.
Это граф связей сообщений внутри одного чата, а не knowledge graph всех людей, проектов и чатов. Native topic ограничивает эвристики, но не равен восстановленному разговору. Пропущенные reply parents, неполная история и перемешанные обсуждения могут ухудшать группировку.
Build запускается явно; обычная синхронизация не перестраивает автоматически все чаты. Новый build публикует новые memberships и conversation IDs. Предыдущий законченный build доступен до готовности замены; ошибка не должна показывать половину нового результата. После rebuild заново получите список разговоров, а не используйте их IDs как вечные идентификаторы.
Агент может улучшить связи: посмотреть batch status, получить пачку сообщений, предложить родителей, записать структурированный ответ и запустить rebuild. CLI сам не вызывает LLM для связывания. Ответы, относящиеся к изменённым/удалённым сообщениям или родителям, становятся stale и исключаются из последующих builds.
tg conversations build --chat "Project team"
tg conversations list --chat "Project team" --json
max conversations batches status --chat "Project team" --json
4. Embeddings частей разговора
Build разрезает разговор по границам сообщений на text chunks с целевым размером 1 200 символов, включая имя автора. Одно слишком длинное сообщение остаётся отдельным chunk; input limit модели может обрезать его. Разговор только из media без текста не создаёт text chunk.
Chunk хранит ссылки на первое/последнее сообщение и hash содержимого. Векторы кешируются по model identity и hash: одинаковый текст может использовать готовый вектор, а прерванный embed продолжает оставшиеся chunks. Оригинальные сообщения остаются доказательствами; вектор — производное представление для поиска.
Локальная модель по умолчанию — e5-small, 384 измерения. Дополнительная embeddinggemma — 768 измерений, с обязательным принятием model terms. Файлы моделей зафиксированы и проверяются checksum. Разные модели/размерности в одном semantic comparison не смешиваются.
tg models text download e5-small
tg conversations embed --chat "Project team"
tg conversations embed status --chat "Project team" --json
Локальный embed работает на компьютере. Явно выбранный hosted provider использует настроенный ключ владельца и получает выбранный текст. Для passages команда оценивает оставшуюся работу и запрашивает подтверждение перед внешним embedding, если не указан --yes. Hosted search также отправляет provider текст запроса. Обычному поиску архива внешний embedding provider не нужен.
Перед embed chunk text восстанавливается из текущих сообщений и сверяется с hash. Изменённые chunks пропускаются: нужен rebuild. Новая история также требует нового build/embed, чтобы попасть в этот путь. Semantic lookup использует hash текущего build и не перечитывает fingerprints всех сообщений при каждом поиске: после edits до rebuild могут оставаться старые представления. Наличие векторов не доказывает свежесть архива.
5. Гибридный поиск разговоров
conversations search принимает вопрос обычным языком, не Lucene expression. Две ветки:
- Смысл: запрос векторизуется выбранной моделью; читаются vectors текущих conversation builds в выбранном account/chat, для разговора сохраняется лучший chunk.
- Слова: из вопроса извлекаются слова, объединяются через OR для message search; найденные сообщения переводятся в построенные разговоры.
Списки соединяются reciprocal rank fusion: каждый даёт 1 / (60 + rank), начиная с rank 1. Поле by равно ["meaning"], ["words"] или обоим. summary — metadata разговора (IDs, даты, число сообщений), не сгенерированный текст. score — cosine лучшего chunk, не fusion score и не вероятность верности ответа; у word-only результата score: null.
Векторы хранятся как SQLite blobs. Сейчас они читаются страницами и сравниваются в JavaScript; ANN/vector index и отдельной vector DB нет. Paging ограничивает одновременно загруженные vectors, но общая работа растёт с числом chunks в scope.
Чат с embeddings только другой модели исключается из semantic branch этой модели и перечисляется в embeddedOnlyElsewhere; его построенные разговоры могут дать word matches. История без build не становится conversation result. Текущая команда векторизует query даже для word-only выдачи: выбранная модель должна быть установлена/настроена, её отсутствие не включает автоматически поиск без модели. Ближайший кандидат может существовать и при отсутствии ответа в архиве: проверьте оригиналы.
tg conversations search "Where did we discuss renting a flat?" --chat "Project team" --json
max conversations search "What changed in the project budget?" --json
CLI и MCP используют общие services. Shared MCP schema conversation search принимает query/chat/since/limit, а не все CLI model/provider options. MCP предлагает list/show/search; build и passage embed остаются явной подготовкой. Для векторизации запроса может работать embedding model, но сами поисковые пути не пишут AI-ответ.
6. Контекст и доказательства для агента
После поиска откройте исходное сообщение или разговор. Различайте точное совпадение, semantic candidate, выведенную графом связь и вывод самого агента. Сохраняйте рядом с утверждением locator, чат, дату и релевантный текст.
Хронологический --context не ходит по графу. messages links объясняет отношения и выбранную parent chain, conversations show читает сгруппированные сообщения. Shared evidence packets дополнительно сохраняют source identities, fingerprints, лимиты и truncation metadata. Одна evidence page не доказывает полноту чата.
Read/search/context не отмечают сообщения прочитанными и ничего не отправляют. Fetch истории, build, passage embed и hosted provider — отдельные явные действия. Summary должна сообщать неполноту/устаревание входных данных, а не считать релевантность доказательством.
7. Что показывает playground
Интерактивный пример использует общий parser на 12 вымышленных сообщениях в четырёх чатах. Он показывает строгие совпадения, подсказки field/value, снимаемые фильтры, даты, Matches/All и исходный context. Ошибка редактирования подсвечивается, предыдущая корректная выдача остаётся.
Браузер не открывает аккаунт, не строит разговоры, не вычисляет embeddings и не вызывает живой AI. Короткие cited summaries подготовлены и показываются только при найденных подтверждающих сообщениях. Интерфейс переведён, sample messages — на английском. Реальный движок поддерживает больше полей, чем sample evaluator.
Исходники и дальнейшее чтение
Исследован cli-messaging 0.140.0, commit 680d22e. Ссылки описывают реализацию, не обещают скорость или её наличие в старом установленном binary.
| Область | Реализация |
|---|---|
| Parse, validation, scope, coverage | Message search service, Lucene SQLite executor |
| Граф и lifecycle build | Link rules, conversation service, build persistence |
| Chunks и vectors | Chunking, vector storage/scoring |
| Модели и fusion | Embedding service, model catalog |
| Evidence contract | Evidence service |
Грамматика, поля и пределы — в канонической справке языка. Подготовка и CLI options — в страницах архива Telegram и архива MAX.