Arquitectura de búsqueda
Cómo se conectan la búsqueda de mensajes, los grafos de conversaciones, los embeddings y las fuentes.
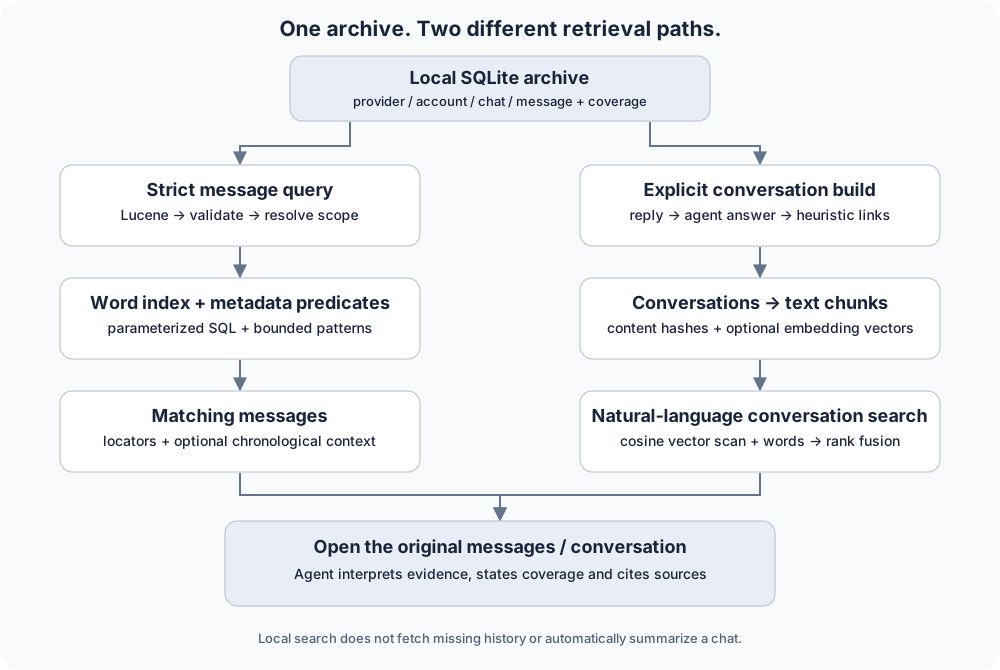
WireCat ofrece dos vías sobre un archivo local compartido: la búsqueda estricta de mensajes encuentra mensajes que cumplen una consulta y la búsqueda de conversaciones encuentra discusiones por significado y palabras. Los grafos y los embeddings ya existen como etapas opcionales, separadas de la búsqueda Lucene de mensajes.
Esta guía describe la implementación examinada el 4 de octubre de 2026. Los detalles de los comandos están en las guías de Telegram y MAX y sus páginas del archivo. Los enlaces al código fijan la versión examinada del motor; no implican que todos los CLI instalados ya usen esa versión del SDK.
Elegir la vía adecuada
| Pregunta | Entrada | Resultado | Preparación |
|---|---|---|---|
| «¿Dónde dijo Alice invoice en octubre, con un archivo?» | messages search | Mensajes coincidentes, localizadores y contexto cercano opcional | Historial guardado; índice de palabras preparado para condiciones de texto |
| «¿Dónde hablamos de alquilar un piso?» | conversations search | Conversaciones ordenadas, fragmentos coincidentes y motivo de recuperación | Conversaciones construidas; embeddings para coincidencias semánticas |
| «¿A qué discusión pertenece este mensaje?» | conversations show / messages links | Miembros, enlaces candidatos y cadena de padres elegida | Conversaciones construidas |
| «¿Qué se escribió alrededor de este mensaje?» | messages context / --context | Vecinos cronológicos en su cuenta y chat | Historial guardado; no necesita grafo ni embeddings |
Un tema nativo del mensajero, una conversación inferida y una ventana cronológica son conceptos distintos. Una conversación puede unir mensajes no adyacentes; los mensajes cercanos pueden tratar otro asunto.
1. Archivo e identidad
Las lecturas, la descarga explícita del historial y la captura de novedades habilitada guardan mensajes en SQLite. La búsqueda lee esa copia y no descarga silenciosamente todo el historial remoto. Los identificadores provider/account/chat/message separan mensajes con el mismo número en fuentes diferentes. Los localizadores completos permiten volver al original.
El texto original y los metadatos del proveedor se conservan separados del texto normalizado del índice. El archivo registra rangos de historial y su completitud. Un índice, una conversación construida o un vector no prueban que se haya descargado todo el chat.
La búsqueda estricta empieza en la cuenta activa. --source all o in:all amplía explícitamente el ámbito a las cuentas guardadas; un ámbito de proveedor lo reduce. Los nombres se resuelven dentro del ámbito elegido. Si un nombre es ambiguo, hay que usar un identificador preciso o reducir el ámbito.
La búsqueda de conversaciones está actualmente limitada a una cuenta: sus conversaciones construidas, con filtros opcionales de chat y tiempo. No ofrece un equivalente de --source all. La búsqueda de mensajes entre mensajeros no implica búsqueda semántica entre cuentas.
2. Búsqueda estricta de mensajes con Lucene
El flujo de ejecución:
- Analiza el texto y crea un AST booleano versionado con posiciones para los errores. Lucene define el lenguaje comprobado de consultas; no significa que haya un servidor Elasticsearch ni un índice Java Lucene.
- Un registro común valida campos, valores y operadores. El CLI y las peticiones MCP de texto/AST llegan al mismo servicio.
- Resuelve cuentas, nombres almacenados y límites de fechas.
topic:requiere un único chat obligatorio porque los IDs de temas son locales al chat. - Compila el árbol en condiciones SQLite parametrizadas. Términos y frases usan el índice FTS5 de palabras normalizadas; los metadatos restringen los candidatos.
- Expande comodines/regex de texto mediante el vocabulario. Las condiciones sobre el cuerpo completo y los detectores preset ejecutan comprobaciones acotadas. Regex usa un autómata limitado en lugar de backtracking sin restricciones.
- Ordena solo los mensajes que cumplen la consulta y puede recuperar sus vecinos cronológicos en la cuenta/chat original. La relevancia nunca amplía el conjunto booleano.
El motor implementa text, body, from, chat, date, kind, has, topic, in y los preset admitidos. filename/mime/size/tag, fuzzy/proximity/boost/intervals no están implementados en este perfil y producen errores explícitos.
tg messages search 'invoice AND has:file' --source all --context 2 --json
max messages search 'chat:"Project team" AND date:[2026-10-01 TO 2026-10-31]' --timezone Europe/Madrid --json
text compara palabras normalizadas; body, el texto original completo. Por ejemplo, body:/.*invoice.*/ expresa una condición de subcadena del cuerpo. La sintaxis regex tiene un subconjunto admitido: flags, lookaround y backreferences de JavaScript no son equivalentes.
Una fecha ISO sin hora representa un día de calendario en la zona IANA elegida. Un límite superior inclusivo incluye todo el día; uno exclusivo lo excluye. Los límites contemplan el horario de verano, sin suponer días de exactamente 24 horas.
Si el índice no está preparado, la búsqueda estricta solicita mantenimiento en vez de devolver coincidencias aproximadas por subcadena. Se limitan bytes del query, profundidad del árbol, tamaño del autómata, expansión del vocabulario, candidatos, bytes leídos, trabajo y tiempo. Agotar un presupuesto es un error, no un resultado vacío completo.
La respuesta incluye versiones del query/campos/presets, zona horaria, orden, wordsReady, cuentas/chats cubiertos y completitud, incluso sin coincidencias. Actualmente inventoryComplete: false y lastSyncedAt: null no certifican un inventario completo ni una sincronización reciente. JSONL transmite elementos; JSON conserva esta envoltura.
El descubrimiento legacy y JavaScript --regex son modos explícitos independientes. Sus correcciones y fallback no forman parte de la semántica estricta de Lucene.
3. Reconstruir discusiones con un grafo
conversations build procesa un chat guardado en orden cronológico. Cada mensaje puede tener enlaces candidatos a mensajes anteriores. El padre elegido lo incorpora a una discusión existente; sin padre empieza otra.
La prioridad actual:
- Respuesta del proveedor: una respuesta explícita a un mensaje anterior presente en la construcción tiene prioridad.
- Respuesta del agente: una propuesta válida de tu agente puede elegir un padre anterior o comenzar una nueva conversación.
- Reglas: el candidato con mayor peso derivado de menciones o continuación del mismo autor.
Las menciones examinan hasta 50 mensajes anteriores y respetan los IDs de temas nativos cuando están presentes. La continuación del autor busca entre los últimos 10 mensajes y cinco minutos, también en el mismo tema. Los pesos son heurísticos, no probabilidades calibradas. Las respuestas explícitas pueden apuntar más atrás si su padre existe en el historial cargado.
Es un grafo de relaciones entre mensajes dentro de un chat, no un grafo de conocimiento global de personas, proyectos y chats. Un tema nativo restringe heurísticas, pero no equivale a una conversación inferida. Padres ausentes, historial incompleto y discusiones intercaladas pueden producir agrupaciones imperfectas.
La construcción es explícita: la sincronización normal no reconstruye todos los chats automáticamente. Una nueva construcción publica nuevos miembros e IDs de conversaciones. La anterior sigue disponible hasta que la sustitución esté preparada; un fallo no debe mostrar una versión escrita a medias. Después de reconstruir, vuelve a listar las conversaciones en vez de tratar sus IDs como identidades permanentes.
Tu agente puede mejorar las relaciones: consultar estado de lotes, obtener mensajes, proponer padres, guardar la respuesta estructurada y reconstruir. El CLI no invoca un LLM ocultamente para enlazarlos. Las respuestas cuyos mensajes o padres han cambiado/se han eliminado quedan obsoletas y se excluyen de construcciones posteriores.
tg conversations build --chat "Project team"
tg conversations list --chat "Project team" --json
max conversations batches status --chat "Project team" --json
4. Embeddings de fragmentos de conversaciones
La construcción divide cada conversación en fragmentos de texto de aproximadamente 1.200 caracteres por límites de mensajes, incluyendo los nombres de autores. Un mensaje demasiado largo ocupa su propio fragmento; el límite de entrada del modelo puede truncarlo. Una conversación solo de medios sin texto no crea fragmentos de texto.
Cada fragmento conserva referencias al primer/último mensaje y un hash de contenido. Los vectores se guardan por identidad del modelo y hash: el texto idéntico puede reutilizar un vector y una ejecución interrumpida continúa con lo pendiente. Los mensajes originales son la evidencia; el vector es una representación derivada para recuperar candidatos.
El modelo local predeterminado es e5-small, con 384 dimensiones. embeddinggemma es opcional, tiene 768 y exige aceptar sus condiciones. Los archivos están fijados y se comprueban sus checksums. No se mezclan modelos/dimensiones diferentes en una comparación semántica.
tg models text download e5-small
tg conversations embed --chat "Project team"
tg conversations embed status --chat "Project team" --json
La ejecución local permanece en el equipo. Los proveedores hosted elegidos explícitamente usan la clave configurada del propietario y reciben el texto seleccionado. Antes de enviar pasajes, el comando estima el trabajo pendiente y pide confirmación, salvo que se confirme mediante --yes. Una búsqueda hosted también envía el texto del query al proveedor. La búsqueda ordinaria del archivo no requiere ningún proveedor de embeddings externo.
Antes de calcular el vector, se reconstruye el texto actual y se compara con su hash. Los fragmentos cambiados se omiten y necesitan reconstrucción. El nuevo historial también requiere construcción/embedding para entrar en esta vía. La consulta semántica usa hashes de la construcción actual; no revalida todos los mensajes en cada consulta. Tras una edición pueden persistir representaciones anteriores hasta reconstruir y calcular embeddings. Tener vectores no demuestra frescura del archivo.
5. Recuperación híbrida de conversaciones
conversations search acepta una pregunta natural, no una expresión Lucene. Ejecuta dos ramas:
- Significado: convierte el query con el modelo elegido, examina vectores de las construcciones actuales en la cuenta/chat y conserva el mejor fragmento de cada conversación.
- Palabras: extrae palabras, las une con OR para buscar mensajes y los relaciona con sus conversaciones construidas.
Combina las listas mediante reciprocal rank fusion: cada una aporta 1 / (60 + rank), comenzando en 1. by indica ["meaning"], ["words"] o ambos. summary contiene metadatos de conversación (IDs, fechas, número de mensajes), no texto generado. score es el coseno del mejor fragmento, no la puntuación de fusión ni la probabilidad de una respuesta correcta; las coincidencias solo de palabras tienen score: null.
Los vectores son blobs de SQLite. La implementación los lee por páginas y calcula similitud en JavaScript: no tiene un índice ANN/vectorial ni una base vectorial separada. Las páginas acotan los vectores cargados a la vez, pero el trabajo total crece con los fragmentos del ámbito.
Un chat vectorizado solo con otro modelo queda fuera de la rama semántica del modelo elegido y se identifica en embeddedOnlyElsewhere; sus conversaciones pueden aportar coincidencias léxicas. Historial descargado sin construcción no aparece como conversación. El comando actual codifica el query incluso para resultados solo léxicos: el modelo elegido debe estar instalado/configurado y su ausencia no activa una búsqueda sin modelo. Puede haber candidatos cercanos aunque el archivo no contenga la respuesta: comprueba los originales.
tg conversations search "Where did we discuss renting a flat?" --chat "Project team" --json
max conversations search "What changed in the project budget?" --json
CLI y MCP usan servicios compartidos. El esquema MCP de conversation search admite query/chat/since/limit, no todas las opciones model/provider del CLI. MCP ofrece list/show/search; construir y vectorizar pasajes son preparaciones explícitas. Un modelo puede codificar la pregunta, pero ninguna vía genera por sí misma una respuesta de IA.
6. Contexto y evidencia para un agente
Después de recuperar candidatos, abre los mensajes o la conversación originales. Distingue una coincidencia exacta, un candidato semántico, una relación inferida por el grafo y una conclusión del agente. Conserva el localizador, chat, fecha y texto relevante junto a cada afirmación.
El --context cronológico no recorre el grafo. messages links explica relaciones y la cadena de padres; conversations show lee los mensajes agrupados. Los paquetes de evidencia compartidos añaden identidades, fingerprints, límites y metadatos de truncamiento. Una página de evidencia tampoco prueba que el historial esté completo.
Leer/buscar/contexto no marca mensajes como leídos ni envía mensajes. Descargar historial, construir, vectorizar pasajes y usar proveedores externos son acciones explícitas separadas. Un resumen debe declarar datos incompletos/obsoletos en vez de tratar relevancia como prueba.
7. Qué demuestra el playground
El playground interactivo usa el parser compartido con 12 mensajes ficticios en cuatro chats. Demuestra coincidencias estrictas, sugerencias de campos/valores, filtros reversibles, fechas, Matches/All y contexto original. Los errores destacan el segmento incorrecto y conservan los últimos resultados válidos.
El navegador no abre cuentas, reconstruye conversaciones, calcula embeddings ni invoca IA real. Sus resúmenes citados son ejemplos preparados, visibles cuando se recupera su evidencia. La interfaz está traducida y los mensajes ficticios siguen en inglés. El motor real admite más campos que el evaluador de ejemplo.
Código y lecturas adicionales
Fuente examinada: cli-messaging 0.140.0, commit 680d22e. Son referencias de implementación, no garantías de rendimiento ni afirmaciones sobre un binary antiguo instalado.
| Responsabilidad | Implementación |
|---|---|
| Parse, validation, scope, coverage | Servicio de mensajes, ejecutor SQLite Lucene |
| Grafo y ciclo de construcción | Reglas, servicio de conversaciones, persistencia |
| Fragmentos y vectores | División, almacenamiento/similitud |
| Modelos y fusión | Servicio de embeddings, catálogo |
| Contrato de evidencia | Servicio de evidencia |
Consulta la referencia canónica del lenguaje para gramática/campos/límites y los archivos de Telegram y MAX para preparación y opciones.